高速网络架构
800Gbps RDMA 高速互联;支持 GPUDirect RDMA 与 InfiniBand;卡间通信最高 22GB/s+,集群延迟微秒级
800Gbps RDMA 高速互联;支持 GPUDirect RDMA 与 InfiniBand;卡间通信最高 22GB/s+,集群延迟微秒级
预装 CUDA 驱动、TensorFlow、PyTorch等主流框架镜像;提供 ComfyUI、LLaMA-Factory、Qwen3 等多种应用镜像
数据安全合规;1V1专属技术团队,秒级响应;东数西算布局,低碳资源稳定供应
灵活付费(按时 / 包月 / 包年),降低投入成本;先试用再长租续费,优惠形式多样;20 余款卡型,适配推理训练全流程
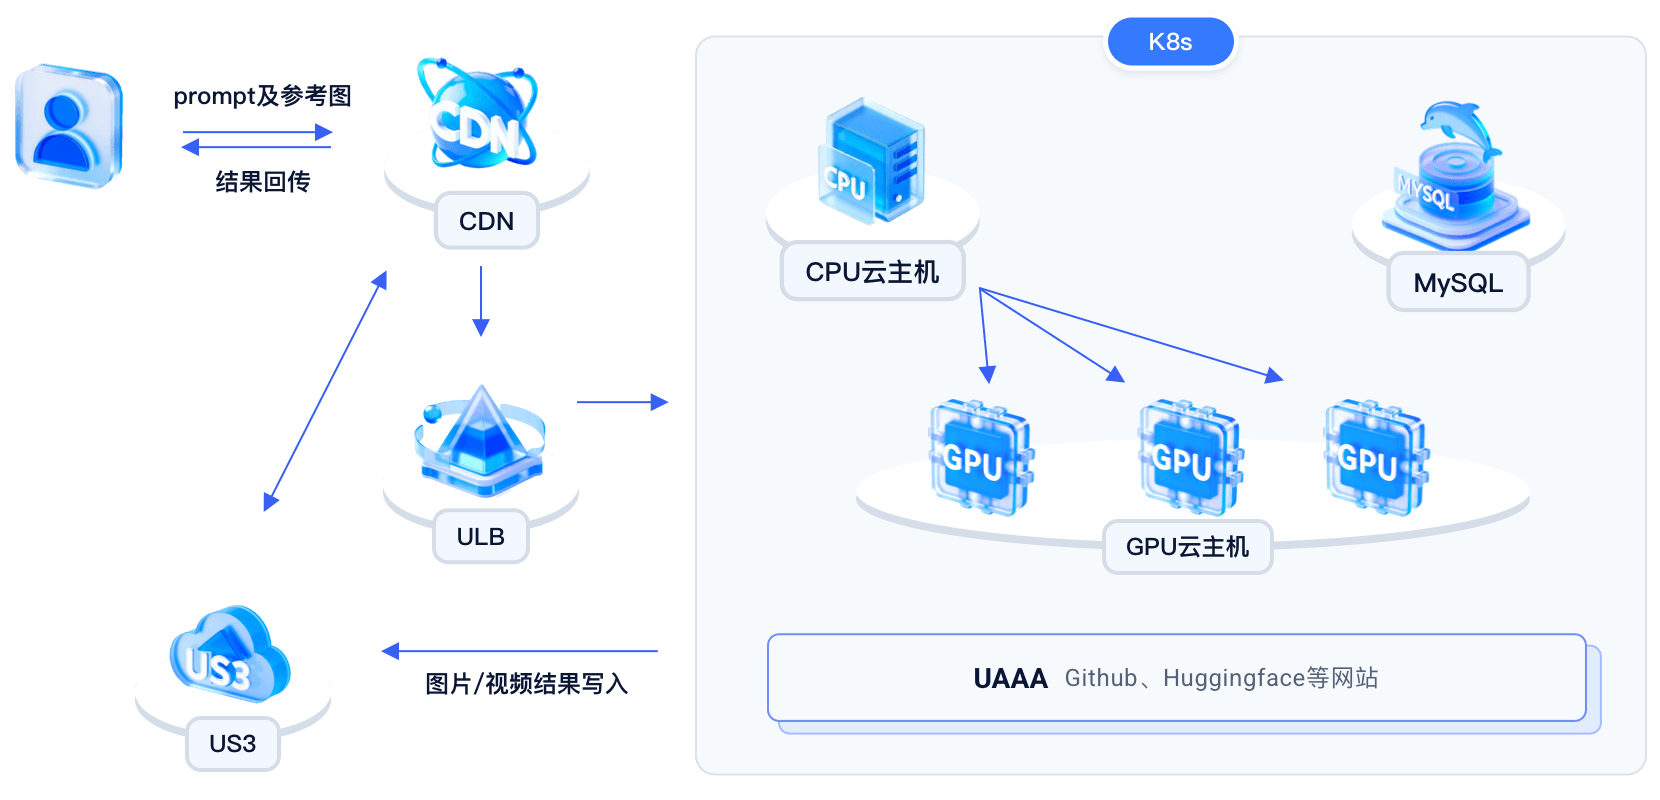
电商商品图自动生成、游戏资产生产、广告营销短视频生成、C端 AI 绘画 APP、企业级 AIGC 创作平台。
方案优势
| 机型 | 显存 | 显存带宽 | 核心算力(FP16) | 网络互联 | 核心优势 |
|---|---|---|---|---|---|
| RTX 40 系 | 24G | 1.0 TB/s | 83 TFLOPS | PCIe 4.0 x16 | 推理性价比之王,场景适配广 |
| RTX 40 系(48G) | 48GB | ~1.2 TB/s(估算) | 83 TFLOPS | PCIe 4.0 x16 | 超大显存,专业创作与中等规模训练 |
| RTX 50 系 | 32GB | 1.79 TB/s | 105 TFLOPS | PCIe 5.0 x16 | 游戏与AI性能巅峰,下一代架构 |
| RTX 3080 Ti | 12GB | 912 GB/s | 34 TFLOPS | PCIe 4.0 x16 | 高性价比,主流AI计算与图形处理 |
| RTX 30 系 | 24GB | 936 GB/s | 36 TFLOPS | PCIe 4.0 x16 | 大显存多任务,适合算法开发与渲染 |
| Tesla P40 | 24GB | 347 GB/s | 12 TFLOPS | PCIe 3.0 x16 | 大显存低成本推理,高密度部署 |
| Tesla T4 | 16GB | 320 GB/s | 8.1 TFLOPS | PCIe 3.0 x16 | 高能效比推理,边缘计算优选 |
| Tesla V100 | 16GB | 897 GB/s | 15 TFLOPS | PCIe 3.0 x16 | 双精度计算强,支持NVLink,传统HPC |
| A100 | 40GB / 80GB | 1.56 TB/s / 1.94 TB/s | 19 TFLOPS | PCIe 4.0 x16 | 大模型训练首选,AI计算绝对性能 |
| A800 | 80GB | 1.94 TB/s | 19 TFLOPS | PCIe 4.0 x16 | A100替代方案,专供中国市场 |